PDF, Excel, documenti scansionati e immagini elaborati con OCR tramite Google Document AI e Gemini per classificazione e estrazione strutturata. Layout KID eterogenei, tabelle multilingua e scansioni rumorose confluiscono in un unico schema normalizzato.
Categorizzazione degli asset, matching degli ISIN, arricchimento via web, analisi dei documenti KID ed estrazione dei costi su fonti eterogenee. Ogni campo estratto è abbinato a un punteggio di fiducia e a un percorso di correzione in un click per l'analista.
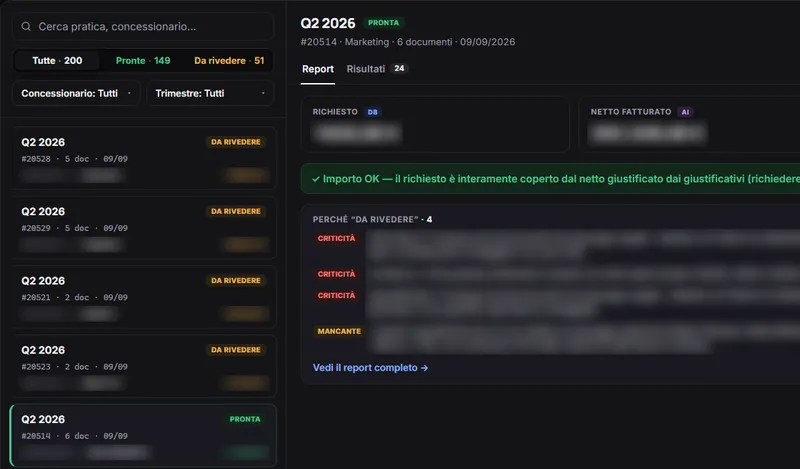
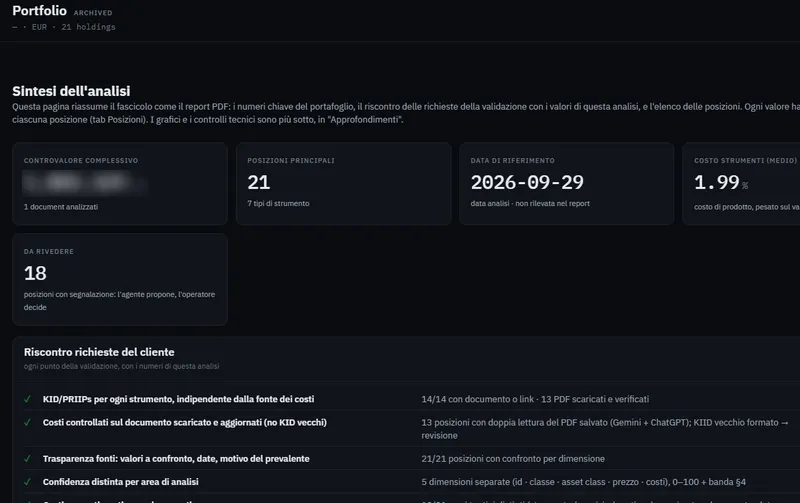
Meridian è l'applicazione che ho sviluppato per tutto il flusso: l'analista carica un estratto (un PDF, una foto, uno zip) e ottiene una sintesi con il controvalore, le posizioni e i tipi di strumento, il costo medio dei prodotti, i documenti KID/PRIIPs trovati e verificati e le posizioni da rivedere, dove l'agente propone e l'operatore decide. Ogni valore ha una fonte e una confidenza da 0 a 100, e una checklist mostra punto per punto come sono soddisfatte le richieste del cliente: costi letti due volte dal PDF salvato (Gemini e ChatGPT), tipi di costo separati e mai sommati, pesi calcolati con una formula esplicita e strumenti non chiari lasciati vuoti invece che indovinati.
La vista delle posizioni elenca ogni strumento con ISIN, categoria, classificazione e relativa confidenza, prezzo, peso, fonte del documento KID (per esempio Bloomberg) e costo annuo, con filtri ed esportazione CSV completa. Un report PDF riassume tutta l'analisi.
Ogni esecuzione conserva un log completo: i file vengono riassunti e classificati (per esempio un estratto delle posizioni correnti), un passaggio di analisi consolida le posizioni e riconcilia il totale calcolato con quello dell'estratto, gli ISIN vengono puliti e arricchiti con ricerche web e verifiche di prezzo entro il 5% e poi il 10%, le posizioni incerte vengono segnalate per la revisione manuale e gli ultimi prezzi arrivano da Bloomberg in un unico lotto. Ogni fase salva il risultato intermedio, così ogni numero si può ricostruire.
Contributo al design del database per lo storage degli asset e il tracking storico, garantendo tracciabilità del dato e processing GDPR-compliant lungo tutta la pipeline.
Generazione di report professionali PDF ed Excel con benchmark "Vecchio vs Nuovo"; sviluppo di un'applicazione prototipo e di un layer API per l'intero flusso da ingestione a reportistica.